Vad är robots.txt?
Robots.txt är en fil som ligger på din hemsida och fungerar som en instruktion till sökmotorerna. I filen kan du ge direktiv för hur Googlebot och andra sökmotorers crawlers får crawla olika delar av din webbplats. Genom att använda robots.txt kan du alltså ta större kontroll över vilket innehåll sökmotorerna kan komma åt vid crawling.
Det är viktigt att skilja på crawling och indexering. Robots.txt används för att styra crawling, inte för att direkt tala om för Google vilka sidor som ska eller inte ska indexeras. En URL som blockeras i robots.txt kan fortfarande indexeras om Google exempelvis hittar den via länkar på andra webbplatser. Om du vill förhindra indexering av en sida behöver du i stället använda exempelvis noindex.
Så fungerar robots.txt
Vid crawling av en sida besöker en crawler webbplatsen och läser av robots.txt-filen. I filen finns instruktioner om vilka delar av webbplatsen som får crawlas och vilka som ska undvikas. När sökmotorn stöter på en URL som omfattas av en Disallow-regel ska den inte crawla innehållet på URL:en.
Robots.txt döljer inte innehåll från sökmotorerna. Om andra sidor länkar till en blockerad URL kan sökmotorn ändå hitta den och visa den i sökresultatet, även utan att ha crawlat innehållet.
Skapa och ladda upp en robots.txt-fil
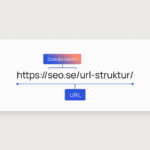
För att skapa en robots.txt-fil behöver du skapa en vanlig textfil med namnet robots.txt och sedan ladda upp den till webbplatsens rotmapp. Det innebär att filen ska kunna nås direkt på exempelvis https://www.exempel.se/robots.txt.
Du behöver inte använda något särskilt program för att skapa filen. En vanlig textredigerare fungerar, så länge filen sparas som ren text och får filändelsen.
1. Skapa filen
Öppna exempelvis Anteckningar i Windows eller en annan enkel textredigerare och skapa en ny fil. Spara den som robots.txt. Kontrollera att filen verkligen heter robots.txt och inte exempelvis robots.txt.txt.
Fundera på om du faktiskt behöver blockera något. En robots.txt-fil behöver inte innehålla många regler, och du ska inte lägga till Disallow bara för att du kan.
2. Lägg till dina regler
Varje regel består framför allt av ett User-agent och ett Allow eller Disallow. User-agent anger vilken crawler regeln gäller och Disallow anger vilken sökväg som inte ska crawlas.
Om regeln ska gälla alla crawlers kan du använda User-agent: *.
Exempel:
-
User-agent: *
-
Disallow: /admin/
-
Disallow: /kundvagn/
I exemplet ovan får alla crawlers instruktionen att inte crawla URL:er som börjar med /admin/ eller /kundvagn/.
Du kan också använda Allow om du vill tillåta en specifik sökväg som annars omfattas av en bredare Disallow-regel.
3. Lägg till din sitemap
Det är vanligt att även ange webbplatsens sitemap i robots.txt. Det görs med Sitemap följt av den fullständiga URL:en till sitemap-filen.
-
User-agent: *
-
Disallow: /admin/
-
Disallow: /kundvagn/
-
Sitemap: https://www.exempel.se/sitemap.xml
Sitemap-raden är inte en instruktion om vad som får crawlas, utan talar om var sökmotorerna kan hitta webbplatsens sitemap.
4. Ladda upp robots.txt till webbplatsen
När filen är klar behöver den laddas upp till webbplatsens rotmapp. Hur du gör detta beror på hur webbplatsen är byggd och vilket webbhotell eller CMS du använder.
På en webbplats där du har tillgång till webbhotellets filhanterare kan du vanligtvis:
-
Logga in på webbhotellets kontrollpanel
-
Öppna filhanteraren och gå till webbplatsens rotmapp
-
Ladda upp filen robots.txt
-
Kontrollera att filen ligger på rätt nivå och inte i exempelvis en undermapp
Om du använder FTP kan du i stället ansluta till webbplatsens server med en FTP-klient och ladda upp robots.txt till rotmappen där webbplatsens filer ligger.
Använder du ett CMS som WordPress kan robots.txt dessutom hanteras på olika sätt beroende på hur webbplatsen är konfigurerad. Många WordPress-installationer genererar en virtuell robots.txt automatiskt, vilket innebär att du inte alltid behöver skapa och ladda upp en fysisk fil manuellt.
5. Kontrollera att filen fungerar
När filen är uppladdad kan du kontrollera att den är åtkomlig genom att skriva in din domän följt av /robots.txt i webbläsaren:
https://www.exempel.se/robots.txt
Du ska då se innehållet i robots.txt-filen. Om du får ett 404-fel eller om en webbsida visas i stället behöver du kontrollera att filen ligger på rätt plats och serveras som en vanlig textfil.
Kontrollera också reglerna noggrant innan du publicerar ändringar. En felaktig Disallow-regel kan göra att sökmotorer inte kan crawla viktiga delar av webbplatsen.
Google anger att robots.txt ska vara en UTF-8-kodad textfil och att filen har en storleksgräns på 500 KiB. Innehåll efter den gränsen ignoreras.
Så här kan din robots.txt-fil se ut
-
User-agent: *
-
Disallow: /admin/
-
Disallow: /kundvagn/
-
Sitemap: https://www.exempel.se/sitemap.xml
I exemplet ovan betyder reglerna:
-
User-agent: * – reglerna gäller alla crawlers
-
Disallow: /admin/ – crawling av URL:er under /admin/ ska undvikas
-
Disallow: /kundvagn/ – crawling av URL:er under /kundvagn/ ska undvikas
-
Sitemap: https://www.exempel.se/sitemap.xml – anger var webbplatsens sitemap finns
Skapa med hjälp av WordPress robots.txt
Om du använder WordPress som plattform för din hemsida finns det flera plugins som kan hjälpa dig att skapa och hantera din robots.txt-fil. Ett exempel på ett sådant plugin är ”WP Robots Txt”. WordPress kan också hantera robots.txt automatiskt, så kontrollera först om det redan finns en robots.txt på din webbplats innan du skapar en ny fil.
Besök https://www.dindoman.se/robots.txt för att se om en robots.txt redan finns och vilka regler den innehåller.
Om du använder ett SEO-plugin eller en annan WordPress-lösning som låter dig redigera robots.txt kan du normalt göra ändringarna direkt där, utan att ladda upp en separat fil via webbhotellet.
Sitemap
En sitemap är en fil som innehåller URL:er till sidor på din webbplats som du vill att sökmotorerna ska känna till. Genom att inkludera en sitemap i din robots.txt-fil kan du göra det enklare för sökmotorerna att hitta webbplatsens URL:er. Det innebär dock inte att sidorna automatiskt crawlas eller indexeras.
Testa din robots.txt-fil
När du har skapat eller ändrat din robots.txt-fil bör du kontrollera att reglerna fungerar som tänkt. Börja med att öppna https://www.dindoman.se/robots.txt och kontrollera att rätt fil visas. Google har en egen robots.txt tester. Instruktioner för hur du använder det hittar du hos Google. Observera att du behöver ha lagt till din domän i Google Search Console för att kunna använda verktyget.
Var särskilt noga med att kontrollera att viktiga delar av webbplatsen inte råkar blockeras. En bred regel som Disallow: / blockerar exempelvis crawling av hela webbplatsen för den crawler som regeln gäller.
Blockera specifika sökmotorer
Utöver att blockera vissa sidor kan du också använda robots.txt för att styra vilka sökmotorers crawlers som får crawla din webbplats. Detta kan vara användbart om du exempelvis vill begränsa crawling från en viss sökmotor. Du kan använda User-agent-kommandot för att specificera vilka crawlers reglerna gäller. Tänk dock på att robots.txt är en instruktion som seriösa crawlers förväntas följa, inte en teknisk åtkomstspärr.
Sökmotorer som ignorerar hela eller delar av filen
Det finns vissa sökmotorer som inte nödvändigtvis följer robots.txt-filen eller som kan ignorera vissa av dess instruktioner. Här är de mest kända:
-
Yandex (rysk sökmotor)
-
Baidu (kinesisk sökmotor)
-
Bingbot (Bings sökrobot)
-
Googlebot-Image (Googles bot för att indexera bilder)
Använd avancerade regler med försiktighet
Robots.txt kan användas för mer avancerade regler, bland annat genom så kallade wildcards. Med * kan du matcha valfria tecken och med $ ange slutet på en URL. Det gör det möjligt att exempelvis blockera flera URL-varianter med en och samma regel.
Avancerade regler bör dock användas med försiktighet. Börja med så enkla och tydliga regler som möjligt och testa alltid resultatet innan du använder dem på en viktig webbplats.
Robots.txt wildcard-kommandon
-
* anger 0 eller fler instanser av valfritt giltigt tecken
-
$ anger slutet av URL:en (slugen)
Tänk på detta
Ta hänsyn till ”crawl budget”
Sökrobotarna har en begränsad ”crawl budget”, det vill säga de resurser som de kan lägga på att crawla en webbplats under en viss period. Genom att använda robots.txt kan du styra crawling från delar av webbplatsen som inte behöver besökas av sökmotorerna.
Undvik att blockera viktiga sidor
När du skapar din robots.txt-fil är det viktigt att du inte blockerar viktiga sidor som kan påverka din sökmotoroptimering negativt. När du skapar din robots.txt-fil är det viktigt att du inte blockerar viktiga delar av webbplatsen av misstag. Tänk igenom vilka delar av webbplatsen som sökmotorerna behöver kunna crawla och kontrollera att dessa inte omfattas av en Disallow-regel.
Artikelns innehåll
- Vad är robots.txt?
- Så fungerar robots.txt
- Skapa och ladda upp en robots.txt-fil
- 1. Skapa filen
- 2. Lägg till dina regler
- Exempel:
- 3. Lägg till din sitemap
- 4. Ladda upp robots.txt till webbplatsen
- 5. Kontrollera att filen fungerar
- Så här kan din robots.txt-fil se ut
- Skapa med hjälp av WordPress robots.txt
- Sitemap
- Testa din robots.txt-fil
- Blockera specifika sökmotorer
- Sökmotorer som ignorerar hela eller delar av filen
- Använd avancerade regler med försiktighet
- Robots.txt wildcard-kommandon
- Tänk på detta
- Ta hänsyn till "crawl budget"
- Undvik att blockera viktiga sidor